Domain bio-informatik.de kaufen?
Wir ziehen mit dem Projekt
bio-informatik.de um.
Sind Sie am Kauf der Domain
bio-informatik.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain bio-informatik.de kaufen?
Was sind einige gängige Methoden zur Dimensionalitätsreduktion in der Datenanalyse?
Einige gängige Methoden zur Dimensionalitätsreduktion sind die Hauptkomponentenanalyse (PCA), die lineare Diskriminanzanalyse (LDA) und die t-SNE-Methode. Diese Techniken helfen dabei, die Anzahl der Merkmale in einem Datensatz zu reduzieren, um die Daten besser visualisieren und interpretieren zu können. Durch die Reduzierung der Dimensionalität können auch Overfitting und Rechenaufwand verringert werden. **
Welche Methoden zur Dimensionalitätsreduktion eignen sich besonders gut zur Optimierung von Machine-Learning-Algorithmen?
Hauptkomponentenanalyse (PCA) ist eine beliebte Methode zur Reduzierung der Dimensionalität von Daten, indem sie die Varianz maximiert und irrelevante Informationen eliminiert. Eine weitere effektive Methode ist die t-Distributed Stochastic Neighbor Embedding (t-SNE), die komplexe Datenstrukturen in einem niedrigdimensionalen Raum visualisiert. Feature Selection-Techniken wie Recursive Feature Elimination (RFE) können auch verwendet werden, um die relevantesten Merkmale für die Modellierung auszuwählen. **


Ähnliche Suchbegriffe für Dimensionalitätsreduktion
Top-Angebote
Produkte zum Begriff Dimensionalitätsreduktion:
-
ZOTERNEN Usb-zu-can-bus-analysator-konverteradapter Und -modul Für Effiziente DatenanalyseFunktionen: 1. Virtuelle Ports: CANable 2.0 ist ein kleiner Open-Source-USB-zu-CAN-Analysator, der die virtuellen seriellen Ports Ihres Computers auflistet und als serielle Schnittstelle für den CAN-Bus fungiert. 2. Lokale Schnittstelle: Bei Verwendung der CANable-Firmware wird CANable unter Linux als lokale CAN-Schnittstelle erkannt, was sehr stabil und komfortabel ist. 3. Anwendungsszenarien: CANable 2.0 unterstützt die Standards CAN 2.0A, CAN 2.0B und CAN FD. Es unterstützt außerdem den USB-Typ-C-Anschluss, Online-Firmware-Upgrades und Firmware-Upgrades im DFU-Modus. 4. HOCHFREQUENZPROZESSOR: Der CAN-Analysator verwendet einen leistungsstarken ARM Cortex M4-Prozessor für STM32G431C8T6, der mit bis zu 170 MHz arbeitet und effizient und stabil ist. 5. ANWENDBARES MODELL: Der CANable-Analysator ist mit ARM-basierten Embedded-Plattformen wie RasPi, RasPi Zero, ODROID, BeagleBone usw. kompatibel und eignet sich daher für die Integration in OEM-Produkte. Spezifikationen: Artikeltyp: CAN-Analysator Material: Leiterplatte Mikroprozessor: Für STM32G431C8T6 Kommunikationschip: Für TJA1051T/3 Spannung: DC 3,3 V–5 V CAN FD: Unterstützt CAN 2.0A/B: Unterstützt Firmware: Für CandleLight, für slcan Übertragungsrate: 1 Mbit/s, 2 Mbit/s, 5 Mbit/s ESD-Schutz: 30 kV Lieferumfang: Lieferumfang: 1 x CAN Analysator 1 x USB-Kabel 1 x Verbindungskabel48,59 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
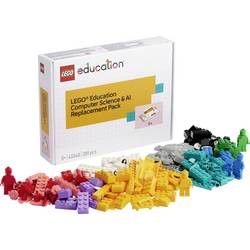
LEGO Education 45545 Informatik & KI Ersatzteilset ab 5 JahrePraktische Ersatzbausteine für das LEGO® Education Informatik- & KI-Set Klasse 1–3 Sorgen Sie mit dem LEGO® Education Ersatzteilset dafür, dass Kindergarten- und Grundschulkinder das praxisnahe Lernen fortsetzen können. Ausgestattet mit 189 LEGO® Steinen und Elementen, die exklusiv für LEGO® Education Informatik und KI entwickelt wurden, ermöglicht das Set Lehrkräften und Schüler*innen, die Unterrichtszeit für spannende Entdeckungen zu nutzen – statt nach fehlenden LEGO® Steinen zu suchen19,95 €*Versand: 4,95 €Sichere Weiterleitung zum Anbieter
-
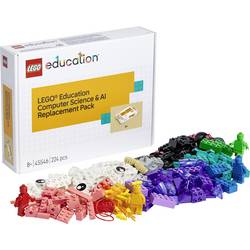
LEGO Education 45546 Informatik & KI Ersatzteilset ab 8 JahreSorgen Sie mit dem LEGO® Education Ersatzteilset dafür, dass Grundschulkinder das praxisnahe Lernen fortsetzen können. Ausgestattet mit 224 LEGO® Steinen und Elementen, die exklusiv für LEGO® Education Informatik und KI entwickelt wurden, ermöglicht das Set Lehrkräften und Schüler*innen, die Unterrichtszeit für spannende Entdeckungen zu nutzen – statt nach fehlenden LEGO® Steinen zu suchen.19,95 €*Versand: 4,95 €Sichere Weiterleitung zum Anbieter


-
Wie kann die Dimensionalitätsreduktion bei der Datenanalyse helfen, komplexe Daten zu vereinfachen und Muster zu erkennen?
Durch die Dimensionalitätsreduktion können redundante oder irrelevante Daten entfernt werden, um die Datenmenge zu vereinfachen. Dies erleichtert die Visualisierung und Interpretation der Daten. Zudem können durch die Reduktion der Dimensionen versteckte Muster und Beziehungen in den Daten identifiziert werden. **
-
Wie können verschiedene Methoden der Dimensionalitätsreduktion in der Datenanalyse eingesetzt werden, um die Komplexität von Datensätzen zu verringern?
Verschiedene Methoden wie PCA, t-SNE oder LDA können verwendet werden, um die Anzahl der Variablen in einem Datensatz zu reduzieren. Dadurch wird die Komplexität verringert und die Daten können besser visualisiert und interpretiert werden. Dies ermöglicht es, Muster und Beziehungen in den Daten effizienter zu erkennen und zu analysieren. **
-
Was sind die grundlegenden Bestandteile einer Hauptkomponentenanalyse und wie können sie zur Dimensionalitätsreduktion in der Datenanalyse eingesetzt werden?
Die grundlegenden Bestandteile einer Hauptkomponentenanalyse sind die Kovarianzmatrix der Variablen, die Eigenwerte und Eigenvektoren der Kovarianzmatrix und die Hauptkomponenten. Durch die Berechnung der Hauptkomponenten können die Daten auf eine kleinere Anzahl von Dimensionen reduziert werden, ohne dabei wichtige Informationen zu verlieren. Dies ermöglicht eine effizientere Datenanalyse und Visualisierung. **
-
Was sind die gängigsten Methoden zur Dimensionalitätsreduktion in der Datenanalyse und wie können sie dazu beitragen, die Datenkomplexität zu verringern?
Die gängigsten Methoden zur Dimensionalitätsreduktion sind Hauptkomponentenanalyse (PCA), t-SNE und LDA. Diese Methoden helfen, die Anzahl der Variablen in einem Datensatz zu reduzieren, indem sie die wichtigsten Informationen extrahieren und in weniger Dimensionen darstellen. Dadurch wird die Datenkomplexität verringert und die Daten können einfacher interpretiert und analysiert werden. **

Was sind die gängigsten Methoden zur Dimensionalitätsreduktion in der Datenanalyse und wie können sie die Effizienz von maschinellen Lernmodellen verbessern?
Die gängigsten Methoden zur Dimensionalitätsreduktion sind PCA (Principal Component Analysis), t-SNE (t-Distributed Stochastic Neighbor Embedding) und LDA (Linear Discriminant Analysis). Diese Methoden helfen, die Anzahl der Variablen in einem Datensatz zu reduzieren, indem sie die wichtigsten Informationen extrahieren und in weniger Dimensionen darstellen. Durch die Reduzierung der Dimensionalität können maschinelle Lernmodelle effizienter trainiert werden, da sie weniger Daten verarbeiten müssen und weniger anfällig für Overfitting sind. **
Was sind die verschiedenen Techniken zur Dimensionalitätsreduktion in der Datenanalyse und wie können sie bei der Verbesserung von Modellen und der Entdeckung von Mustern helfen?
Die verschiedenen Techniken zur Dimensionalitätsreduktion in der Datenanalyse sind z.B. PCA, t-SNE und LDA. Sie helfen dabei, die Anzahl der Variablen zu reduzieren und die Daten besser zu visualisieren. Durch die Reduktion der Dimensionalität können Modelle einfacher interpretiert und Muster schneller entdeckt werden. **
Top-Angebote
Produkte zum Begriff Dimensionalitätsreduktion:
-
moses. PhänoMINT Das große Informatik-RätselbuchPhänoMINT – Das bedeutet: Phänomenale Experimente für neugierige Entdecker*innen im Schulkindalter. Große Themengebiete wie Mathe, Informatik, Naturwissenschaft und Technik, werden spielerisch leicht vermittelt. Durch aktives Erleben und Experimentieren kommen die Kinder den naturwissenschaftlichen Phänomenen unseres Alltags auf die Spur – großer Aha-Effekt inklusive.Informatik für Einsteiger*innen: Dieses Buch kombiniert Rätselspaß mit Grundwissen zur Informatik. Wem gelingt es, die Rakete an allen fliegenden Objekten vorbei zielsicher zur Raumstation zu steuern? So wird ganz nebenbei Programmieren gelernt. Wer kann den Tresor mit Byte-Zahlen knacken? Dabei wird spielerisch codiert. Und wer löst die Cäsar-Verschlüsselung? Schon bald kennt man sich dann auch im Bereich Ver- und Entschlüsselung aus und ist Informatiker*in aus Leidenschaft!Das steckt drin:- Was ist Binärcode?- Wie funktionieren Verschlüsselungen?- Wie arbeiten Bildschirme?- Wie programmiert man?- Wie funktioniert künstliche Intelligenz?- Wie erstellt man eine Datenbank und wofür ist sie gut?Autor*innen: Nicola Berger, Jens RenkenIllustration: Lucie Göpfert12,95 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter
-
ZOTERNEN Usb-zu-can-bus-analysator-konverteradapter Und -modul Für Effiziente DatenanalyseFunktionen: 1. Virtuelle Ports: CANable 2.0 ist ein kleiner Open-Source-USB-zu-CAN-Analysator, der die virtuellen seriellen Ports Ihres Computers auflistet und als serielle Schnittstelle für den CAN-Bus fungiert. 2. Lokale Schnittstelle: Bei Verwendung der CANable-Firmware wird CANable unter Linux als lokale CAN-Schnittstelle erkannt, was sehr stabil und komfortabel ist. 3. Anwendungsszenarien: CANable 2.0 unterstützt die Standards CAN 2.0A, CAN 2.0B und CAN FD. Es unterstützt außerdem den USB-Typ-C-Anschluss, Online-Firmware-Upgrades und Firmware-Upgrades im DFU-Modus. 4. HOCHFREQUENZPROZESSOR: Der CAN-Analysator verwendet einen leistungsstarken ARM Cortex M4-Prozessor für STM32G431C8T6, der mit bis zu 170 MHz arbeitet und effizient und stabil ist. 5. ANWENDBARES MODELL: Der CANable-Analysator ist mit ARM-basierten Embedded-Plattformen wie RasPi, RasPi Zero, ODROID, BeagleBone usw. kompatibel und eignet sich daher für die Integration in OEM-Produkte. Spezifikationen: Artikeltyp: CAN-Analysator Material: Leiterplatte Mikroprozessor: Für STM32G431C8T6 Kommunikationschip: Für TJA1051T/3 Spannung: DC 3,3 V–5 V CAN FD: Unterstützt CAN 2.0A/B: Unterstützt Firmware: Für CandleLight, für slcan Übertragungsrate: 1 Mbit/s, 2 Mbit/s, 5 Mbit/s ESD-Schutz: 30 kV Lieferumfang: Lieferumfang: 1 x CAN Analysator 1 x USB-Kabel 1 x Verbindungskabel48,59 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind einige gängige Methoden zur Dimensionalitätsreduktion in der Datenanalyse?
Einige gängige Methoden zur Dimensionalitätsreduktion sind die Hauptkomponentenanalyse (PCA), die lineare Diskriminanzanalyse (LDA) und die t-SNE-Methode. Diese Techniken helfen dabei, die Anzahl der Merkmale in einem Datensatz zu reduzieren, um die Daten besser visualisieren und interpretieren zu können. Durch die Reduzierung der Dimensionalität können auch Overfitting und Rechenaufwand verringert werden. **
-
Welche Methoden zur Dimensionalitätsreduktion eignen sich besonders gut zur Optimierung von Machine-Learning-Algorithmen?
Hauptkomponentenanalyse (PCA) ist eine beliebte Methode zur Reduzierung der Dimensionalität von Daten, indem sie die Varianz maximiert und irrelevante Informationen eliminiert. Eine weitere effektive Methode ist die t-Distributed Stochastic Neighbor Embedding (t-SNE), die komplexe Datenstrukturen in einem niedrigdimensionalen Raum visualisiert. Feature Selection-Techniken wie Recursive Feature Elimination (RFE) können auch verwendet werden, um die relevantesten Merkmale für die Modellierung auszuwählen. **
-
Wie kann die Dimensionalitätsreduktion bei der Datenanalyse helfen, komplexe Daten zu vereinfachen und Muster zu erkennen?
Durch die Dimensionalitätsreduktion können redundante oder irrelevante Daten entfernt werden, um die Datenmenge zu vereinfachen. Dies erleichtert die Visualisierung und Interpretation der Daten. Zudem können durch die Reduktion der Dimensionen versteckte Muster und Beziehungen in den Daten identifiziert werden. **
-
Wie können verschiedene Methoden der Dimensionalitätsreduktion in der Datenanalyse eingesetzt werden, um die Komplexität von Datensätzen zu verringern?
Verschiedene Methoden wie PCA, t-SNE oder LDA können verwendet werden, um die Anzahl der Variablen in einem Datensatz zu reduzieren. Dadurch wird die Komplexität verringert und die Daten können besser visualisiert und interpretiert werden. Dies ermöglicht es, Muster und Beziehungen in den Daten effizienter zu erkennen und zu analysieren. **
Ähnliche Suchbegriffe für Dimensionalitätsreduktion
-
LEGO Education 45545 Informatik & KI Ersatzteilset ab 5 JahrePraktische Ersatzbausteine für das LEGO® Education Informatik- & KI-Set Klasse 1–3 Sorgen Sie mit dem LEGO® Education Ersatzteilset dafür, dass Kindergarten- und Grundschulkinder das praxisnahe Lernen fortsetzen können. Ausgestattet mit 189 LEGO® Steinen und Elementen, die exklusiv für LEGO® Education Informatik und KI entwickelt wurden, ermöglicht das Set Lehrkräften und Schüler*innen, die Unterrichtszeit für spannende Entdeckungen zu nutzen – statt nach fehlenden LEGO® Steinen zu suchen19,95 €*Versand: 4,95 €Sichere Weiterleitung zum Anbieter
-
LEGO Education 45546 Informatik & KI Ersatzteilset ab 8 JahreSorgen Sie mit dem LEGO® Education Ersatzteilset dafür, dass Grundschulkinder das praxisnahe Lernen fortsetzen können. Ausgestattet mit 224 LEGO® Steinen und Elementen, die exklusiv für LEGO® Education Informatik und KI entwickelt wurden, ermöglicht das Set Lehrkräften und Schüler*innen, die Unterrichtszeit für spannende Entdeckungen zu nutzen – statt nach fehlenden LEGO® Steinen zu suchen.19,95 €*Versand: 4,95 €Sichere Weiterleitung zum Anbieter
-
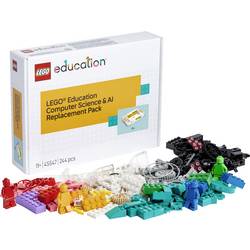
LEGO Education 45547 Informatik & KI Ersatzteilset ab 11 JahreSorgen Sie mit dem LEGO® Education Ersatzteilset dafür, dass Schüler*innen der Mittelstufe das praxisnahe Lernen fortsetzen können. Ausgestattet mit 244 LEGO® Steinen und Elementen, die exklusiv für LEGO® Education Informatik und KI entwickelt wurden, ermöglicht das Set Lehrkräften und Schüler*innen, die Unterrichtszeit für spannende Entdeckungen zu nutzen – statt nach fehlenden LEGO® Steinen zu suchen.19,95 €*Versand: 4,95 €Sichere Weiterleitung zum Anbieter
-
Merkl, Rainer: BioinformatikBioinformatik , Der Marktführer bei den Bioinformatiklehrbüchern in neuer Auflage und mit dem neuen Thema Molekulardynamik Bioinformatik ist eine Kerndisziplin in den modernen Biowssenschaften, von der Biotechnologie über die Biochemie und Molekularbiologie bis zur Molekulargenetik und Molekularmedizin. Sie ist eine essenzielle Grundlage für alle "omics"-Technologien, für die Strukturbiologie, die Systembiologie sowie die synthetische Biologie. Bioinformatik. Grundlagen, Algorithmen, Anwendungen bietet eine umfassende Einführung in die wichtigsten Methoden der Bioinformatik. Der Autor erklärt dabei sowohl die mathematischen und biologischen Grundlagen als auch die wichtigsten Software-Tools und deren Anwendungsbereiche. Schwerpunkte sind Methoden zum Sequenzvergleichs, Verfahren zur Charakterisierung von Proteinfamilien, Algorithmen zur Vorhersage von Protein- und RNA-Strukturen, Methoden des maschinellen Lernens und das Proteindesign. Für die 4. Auflage wurde der Text durchgehend aktualisiert und um ein Kapitel zur Molekulardynamik erweitert. Neu aufgenommene Exkurse zu Meilensteinen der Bioinformatik und aktuellen Anwendungsgebieten lockern den Text auf. Auf der ebenfalls komplett überarbeiteten Begleit-Webseite werden interaktive Lernmodule bereitgestellt, einschließlich mehr als 120 Übungsaufgaben, zum Teil mit Lösungen. Eine perfekte Einführung für alle Studenten der Lebenswissenschaften oder Informatik, die einen Einblick in die gängigen Methoden der Bioinformatik benötigen, sowie ein wertvoller Begleiter für alle, die bereits bioinformatische Werkzeuge nutzen und die zugrundeliegenden Konzepte verstehen möchten. , Sonstige > Gokart Teile , Auflage: 4. Auflage, Erscheinungsjahr: 20220824, Produktform: Leinen, Autoren: Merkl, Rainer, Auflage: 22004, Auflage/Ausgabe: 4. Auflage, Abbildungen: 100 schwarz-weiße und 120 farbige Abbildungen, 30 schwarz-weiße Tabellen, Keyword: Bioinformatik u. Computersimulationen in der Biowissenschaften; Biologie; Biomedizintechnik; Biostatistik; Biowissenschaften; Medizininformatik u. biomedizinische Informationstechnologie; Statistik; Statistische Genetik, Fachschema: Biochemie~Chemie / Biochemie~Bioinformatik~Informatik / Bioinformatik~Biologie / Molekularbiologie~Molekularbiologie~Biotechnologie - Biotechnik~Technologie / Biotechnologie, Fachkategorie: Biotechnologie, Bildungszweck: für die Hochschule, Imprint-Titels: Wiley-Blackwell, Warengruppe: HC/Biochemie/Biophysik, Fachkategorie: DV-gestützte Biologie/Bioinformatik, Thema: Verstehen, Text Sprache: ger, Seitenanzahl: XIX, Seitenanzahl: 728, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Wiley-VCH GmbH, Verlag: Wiley-VCH GmbH, Verlag: Wiley-VCH GmbH, Länge: 250, Breite: 177, Höhe: 41, Gewicht: 1544, Produktform: Gebunden, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Vorgänger: 2168379, Vorgänger EAN: 9783527338207 9783527325948 9783527306626, Herkunftsland: GROSSBRITANNIEN (GB), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0002, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel,79,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die grundlegenden Bestandteile einer Hauptkomponentenanalyse und wie können sie zur Dimensionalitätsreduktion in der Datenanalyse eingesetzt werden?
Die grundlegenden Bestandteile einer Hauptkomponentenanalyse sind die Kovarianzmatrix der Variablen, die Eigenwerte und Eigenvektoren der Kovarianzmatrix und die Hauptkomponenten. Durch die Berechnung der Hauptkomponenten können die Daten auf eine kleinere Anzahl von Dimensionen reduziert werden, ohne dabei wichtige Informationen zu verlieren. Dies ermöglicht eine effizientere Datenanalyse und Visualisierung. **
-
Was sind die gängigsten Methoden zur Dimensionalitätsreduktion in der Datenanalyse und wie können sie dazu beitragen, die Datenkomplexität zu verringern?
Die gängigsten Methoden zur Dimensionalitätsreduktion sind Hauptkomponentenanalyse (PCA), t-SNE und LDA. Diese Methoden helfen, die Anzahl der Variablen in einem Datensatz zu reduzieren, indem sie die wichtigsten Informationen extrahieren und in weniger Dimensionen darstellen. Dadurch wird die Datenkomplexität verringert und die Daten können einfacher interpretiert und analysiert werden. **
-
Was sind die gängigsten Methoden zur Dimensionalitätsreduktion in der Datenanalyse und wie können sie die Effizienz von maschinellen Lernmodellen verbessern?
Die gängigsten Methoden zur Dimensionalitätsreduktion sind PCA (Principal Component Analysis), t-SNE (t-Distributed Stochastic Neighbor Embedding) und LDA (Linear Discriminant Analysis). Diese Methoden helfen, die Anzahl der Variablen in einem Datensatz zu reduzieren, indem sie die wichtigsten Informationen extrahieren und in weniger Dimensionen darstellen. Durch die Reduzierung der Dimensionalität können maschinelle Lernmodelle effizienter trainiert werden, da sie weniger Daten verarbeiten müssen und weniger anfällig für Overfitting sind. **
-
Was sind die verschiedenen Techniken zur Dimensionalitätsreduktion in der Datenanalyse und wie können sie bei der Verbesserung von Modellen und der Entdeckung von Mustern helfen?
Die verschiedenen Techniken zur Dimensionalitätsreduktion in der Datenanalyse sind z.B. PCA, t-SNE und LDA. Sie helfen dabei, die Anzahl der Variablen zu reduzieren und die Daten besser zu visualisieren. Durch die Reduktion der Dimensionalität können Modelle einfacher interpretiert und Muster schneller entdeckt werden. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.